MacBook Pro M1 Max 64GB hay PC RTX 5080: Chạy AI local, ComfyUI nên chọn máy nào?
So sánh MacBook Pro M1 Max 64GB và PC Windows card RTX 5080 khi chạy LLM, ComfyUI: bộ nhớ, tốc độ token/s, thời gian tạo ảnh và gợi ý chọn máy theo nhu cầu.
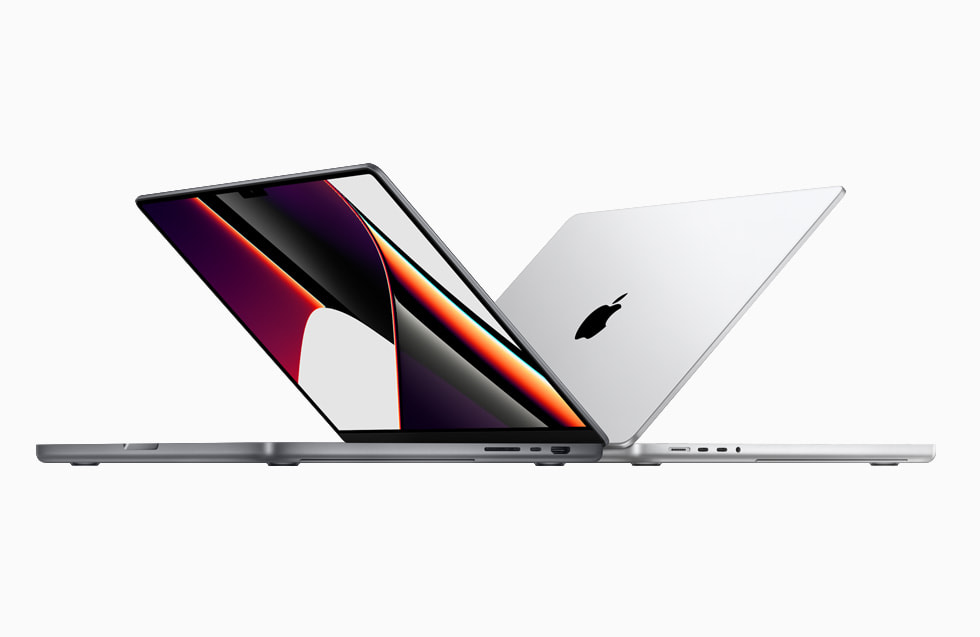
Chạy mô hình AI ngay trên máy tính cá nhân (AI local) đang là nhu cầu của rất nhiều lập trình viên, nhà sáng tạo nội dung và doanh nghiệp nhỏ muốn giữ dữ liệu riêng tư, không phụ thuộc dịch vụ đám mây. Hai lựa chọn được hỏi nhiều nhất trong tầm tiền hợp lý hiện nay là MacBook Pro M1 Max 64GB RAM (hàng đã qua sử dụng) và PC Windows lắp card NVIDIA GeForce RTX 5080.
Hai cỗ máy đi theo hai triết lý hoàn toàn khác nhau: một bên có bộ nhớ lớn nhưng tốc độ vừa phải, một bên có tốc độ cực cao nhưng bộ nhớ đồ họa chỉ 16GB. Bài viết này phân tích chi tiết từng điểm mạnh, yếu khi chạy mô hình ngôn ngữ lớn (LLM) và đặc biệt là ComfyUI để bạn chọn đúng máy cho công việc của mình.
Điều quan trọng nhất khi chạy AI local: bộ nhớ và băng thông
Trước khi so sánh, cần hiểu hai thông số quyết định gần như mọi thứ khi chạy AI trên máy cá nhân:
- Dung lượng bộ nhớ mà GPU dùng được: quyết định mô hình lớn cỡ nào có thể nạp vào. Một mô hình 70 tỷ tham số (70B) nén 4-bit cần khoảng 40–43GB, bản 32B cần khoảng 19–20GB, bản 8B chỉ cần 5–6GB.
- Băng thông bộ nhớ: quyết định tốc độ sinh chữ (token/giây). Mỗi token sinh ra, máy phải đọc gần như toàn bộ trọng số mô hình một lần, nên băng thông càng cao thì chữ chạy ra càng nhanh.
- Sức tính toán (TFLOPS, nhân Tensor): quyết định tốc độ xử lý câu lệnh dài và tốc độ tạo ảnh, video. Đây là phần việc nặng tính toán, không chỉ đọc bộ nhớ.
Nếu mô hình không vừa bộ nhớ GPU, phần dư phải đẩy sang RAM hệ thống hoặc CPU, tốc độ có thể giảm 5–10 lần. Vì vậy câu hỏi "máy nào mạnh hơn" luôn phải đi kèm "chạy mô hình gì, lớn cỡ nào".
Thông số MacBook Pro M1 Max 64GB và RTX 5080
Chip M1 Max ra mắt tháng 10/2021 cùng MacBook Pro 14 inch và 16 inch, có CPU 10 nhân, GPU 24 hoặc 32 nhân và hỗ trợ tối đa 64GB bộ nhớ hợp nhất (unified memory) với băng thông 400GB/s. Điểm đặc biệt là CPU và GPU dùng chung một vùng nhớ, nên GPU có thể sử dụng phần lớn trong 64GB này để nạp mô hình AI.
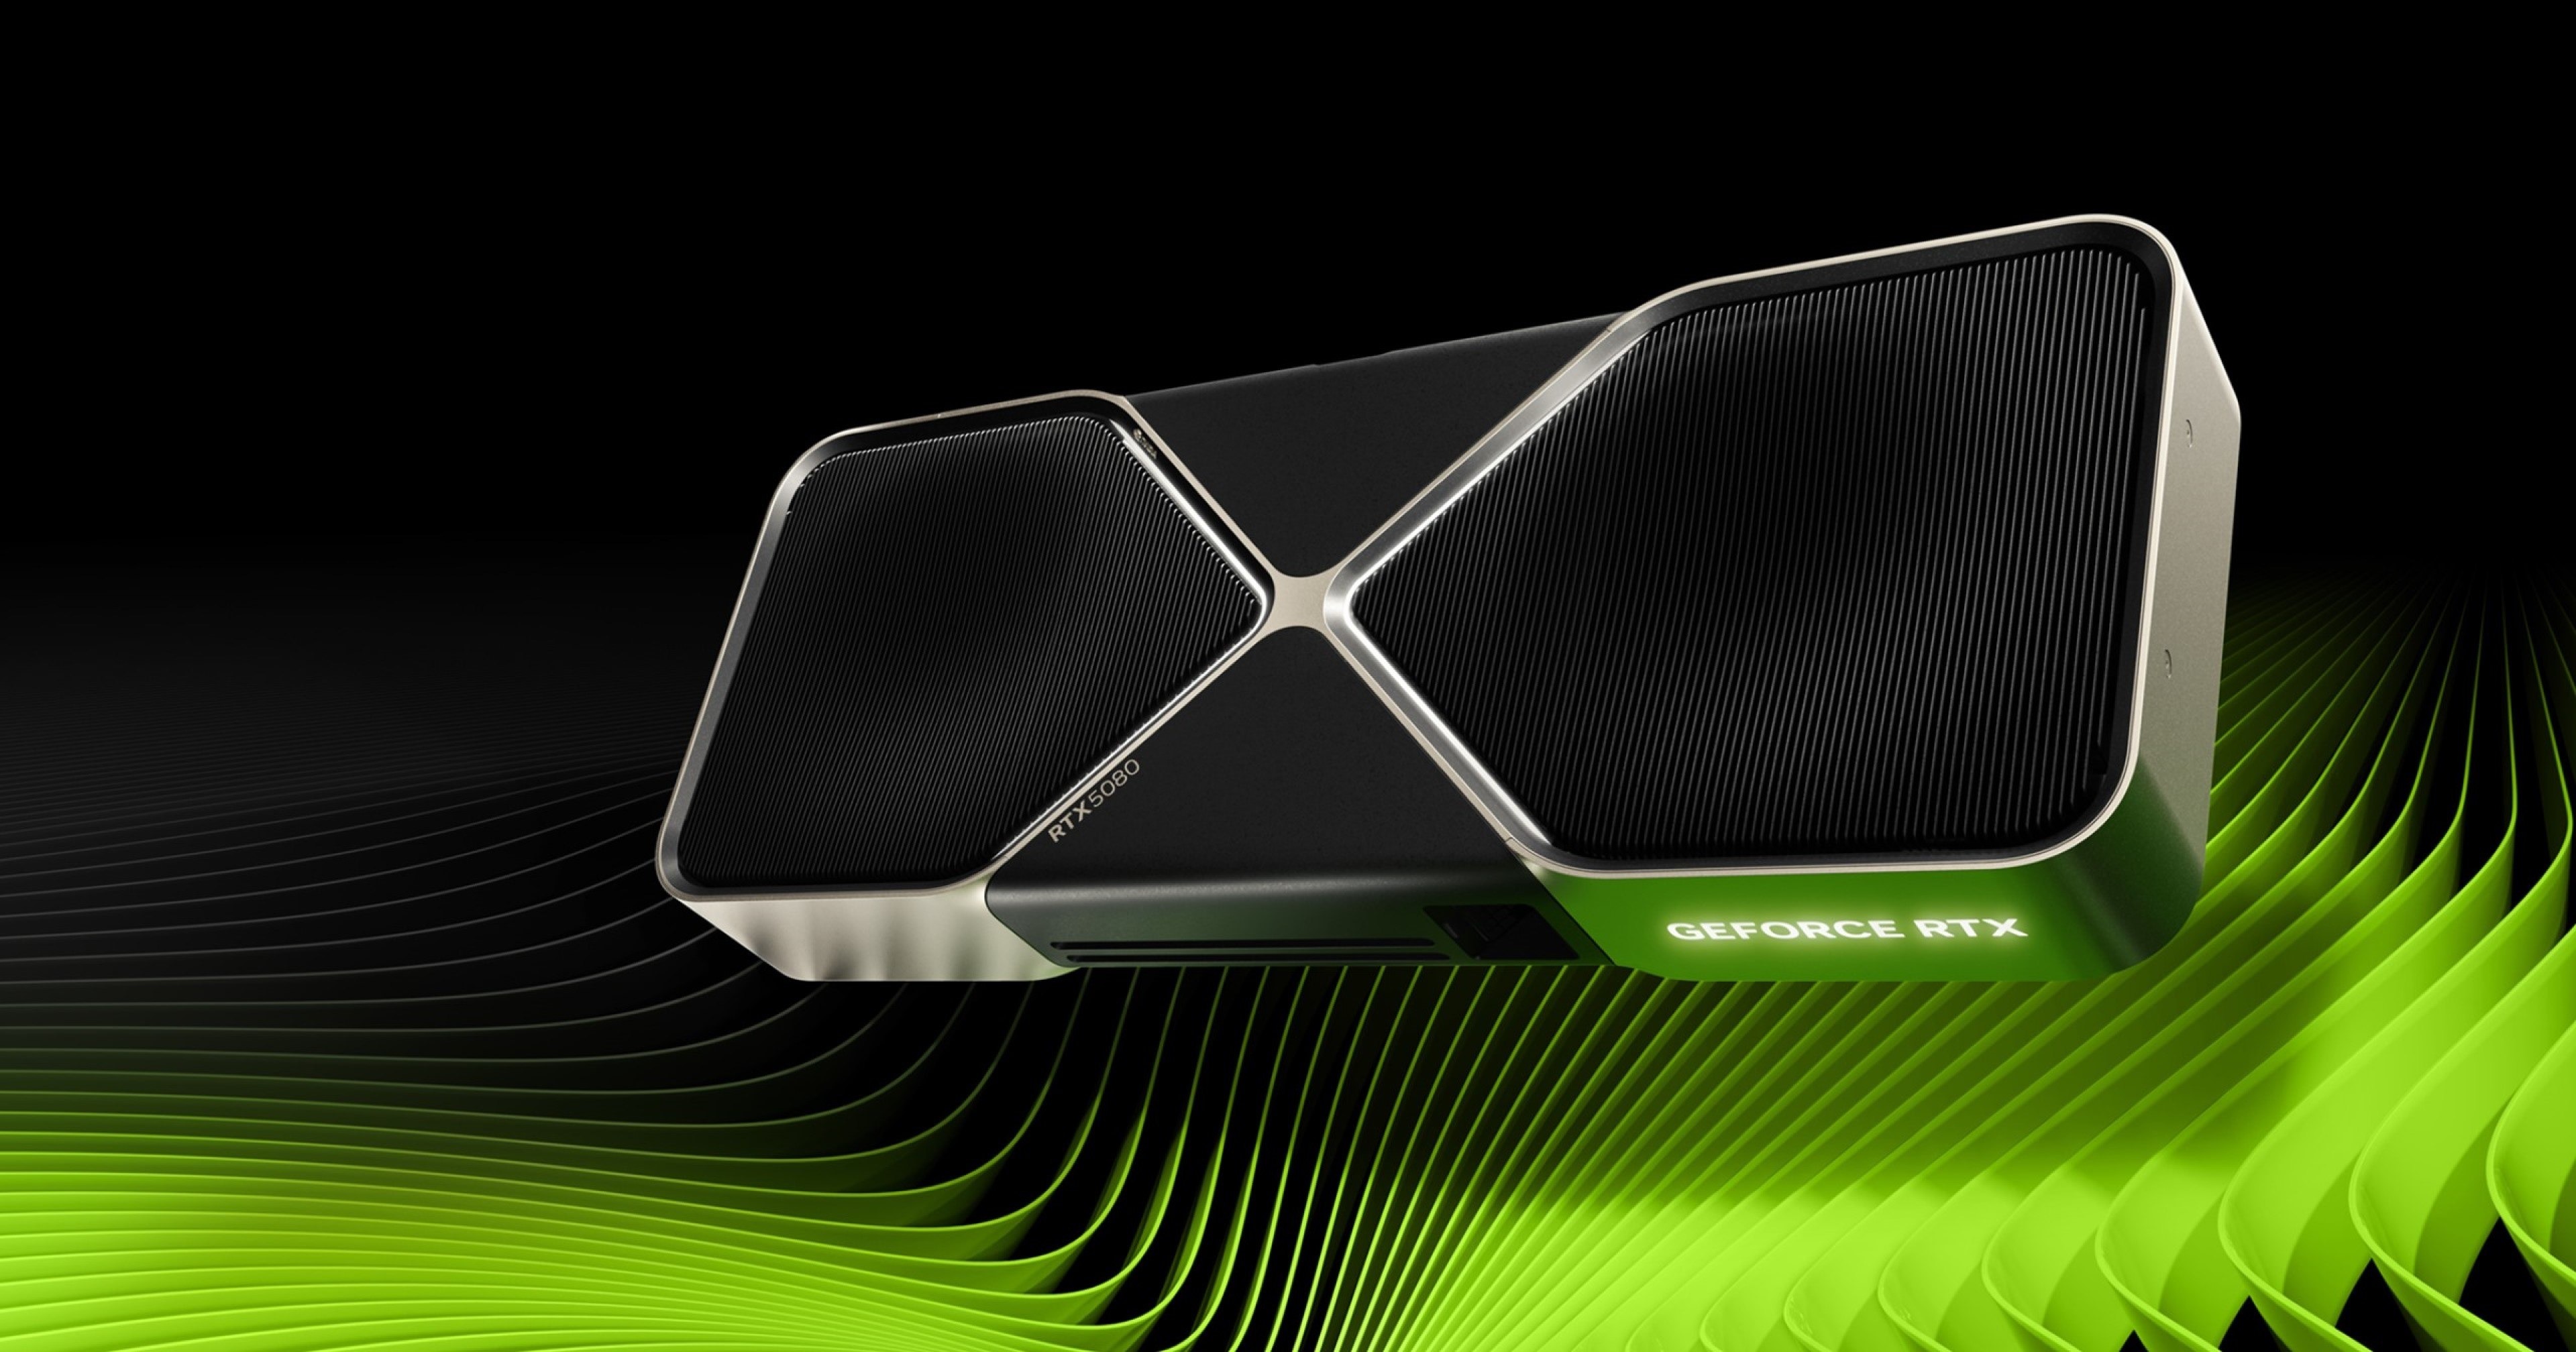
GeForce RTX 5080 dùng kiến trúc Blackwell, ra mắt đầu năm 2025, có 10.752 nhân CUDA, 16GB GDDR7 bus 256-bit với băng thông khoảng 960GB/s, nhân Tensor thế hệ 5 hỗ trợ định dạng FP4/FP8 và đạt khoảng 1.801 AI TOPS theo công bố của NVIDIA. Bản laptop cũng có 16GB GDDR7 nhưng ít nhân hơn (7.680 nhân CUDA) và công suất thấp hơn nên chậm hơn bản desktop.
| Tiêu chí | MacBook Pro M1 Max 64GB | PC RTX 5080 (desktop) |
|---|---|---|
| Bộ nhớ GPU dùng được | Khoảng 48GB mặc định (có thể nới lên ~56GB) | 16GB GDDR7 |
| Băng thông bộ nhớ | 400GB/s | ~960GB/s |
| Hỗ trợ FP8 / FP4 phần cứng | Không | Có (nhân Tensor thế hệ 5) |
| Nền tảng phần mềm AI | Metal, MLX, llama.cpp | CUDA, TensorRT, PyTorch đầy đủ |
| Điện năng khi tải nặng | Khoảng 60–100W cả máy | GPU tới 360W, cả máy 550–650W |
| Tính di động | Laptop, có pin, mang đi được | Máy bàn cố định |
| Độ ồn | Rất êm | Ồn hơn khi tải nặng lâu |
Nhìn bảng có thể thấy ngay: M1 Max thắng về dung lượng bộ nhớ, RTX 5080 thắng về tốc độ và hệ sinh thái phần mềm. Mọi khác biệt khi dùng thực tế đều bắt nguồn từ hai điểm này.
Chạy mô hình ngôn ngữ lớn (LLM): mỗi máy thắng một kiểu
Với LLM chạy qua Ollama, LM Studio hay llama.cpp, kết quả phụ thuộc rất nhiều vào kích thước mô hình. Các con số dưới đây là mức tham khảo với mô hình nén 4-bit (Q4), thay đổi theo phần mềm, phiên bản và cấu hình máy.
| Mô hình (Q4) | MacBook Pro M1 Max 64GB | PC RTX 5080 16GB | Bên lợi thế |
|---|---|---|---|
| 7B–8B (Llama 3.1 8B, Qwen 7B) | Khoảng 45–60 token/s | Khoảng 130–170 token/s | RTX 5080 |
| 12B–14B (Gemma, Qwen 14B) | Khoảng 25–35 token/s | Khoảng 70–90 token/s | RTX 5080 |
| 24B (Mistral Small) | Khoảng 15–20 token/s | Khoảng 45–60 token/s, vừa sát 16GB | RTX 5080 (ngữ cảnh ngắn) |
| 32B (Qwen 32B, QwQ) | Khoảng 12–15 token/s | Không vừa VRAM, phải đẩy sang RAM: chậm hẳn | M1 Max |
| 70B (Llama 3.3 70B) | Khoảng 5–7 token/s | Khoảng 2–4 token/s (phần lớn chạy trên RAM/CPU) | M1 Max |
RTX 5080 nhanh vượt trội với mô hình vừa 16GB
Với các mô hình từ 14B trở xuống, RTX 5080 sinh chữ nhanh gấp khoảng 2,5–3 lần nhờ băng thông gần 1TB/s. Khác biệt còn lớn hơn ở bước xử lý câu lệnh đầu vào (prompt processing): khi bạn dán một tài liệu dài vài chục trang hoặc dùng RAG, agent lập trình, RTX 5080 có thể nhanh gấp 10–20 lần M1 Max. Trên Mac, việc chờ máy "đọc" xong một ngữ cảnh dài vài chục nghìn token có thể mất cả phút, trong khi PC chỉ vài giây.
M1 Max 64GB chạy được mô hình mà RTX 5080 không chứa nổi
Ngược lại, khi mô hình vượt 16GB, lợi thế đảo chiều. MacBook Pro M1 Max 64GB nạp trọn mô hình 32B, thậm chí 70B nén 4-bit vào bộ nhớ GPU. Tốc độ 5–7 token/s với 70B không nhanh, nhưng vẫn đọc được theo thời gian thực, và quan trọng là chạy ổn định, êm, không cần mua thêm card.
RTX 5080 có thể chạy mô hình lớn bằng cách đẩy một phần sang RAM hệ thống, nhưng khi đó tốc độ bị giới hạn bởi băng thông RAM DDR5 (chỉ khoảng 80–100GB/s), thường chậm hơn cả M1 Max. Riêng các mô hình MoE (chỉ kích hoạt một phần tham số mỗi token, như Qwen3 30B-A3B hay gpt-oss-20b) thì PC vẫn chạy khá tốt nhờ tùy chọn chỉ đưa phần chuyên gia sang CPU.
Mẹo khi chạy LLM trên Mac
- Dùng LM Studio với mô hình định dạng MLX: thường nhanh hơn bản GGUF 10–20% trên Apple Silicon.
- macOS mặc định chỉ cho GPU dùng khoảng 75% bộ nhớ (~48GB với máy 64GB). Có thể nới giới hạn bằng lệnh
sudo sysctl iogpu.wired_limit_mb=57344(mất khi khởi động lại), nhưng nên chừa 6–8GB cho hệ thống. - Chọn mức nén Q4_K_M hoặc 4-bit MLX cho mô hình 70B; Q5–Q6 cho mô hình 32B nếu còn dư bộ nhớ.
- Đóng trình duyệt nhiều tab và ứng dụng nặng để dành bộ nhớ cho mô hình.
Chạy ComfyUI: RTX 5080 thắng áp đảo
Nếu mục tiêu chính là ComfyUI (tạo ảnh bằng Stable Diffusion, SDXL, Flux, Qwen-Image, tạo video bằng Wan, LTX…), câu trả lời rất rõ ràng: chọn PC RTX 5080. Tạo ảnh và video là tác vụ nặng tính toán chứ không chỉ cần bộ nhớ lớn, và đây là sân nhà của GPU NVIDIA.
Tốc độ tạo ảnh chênh lệch hàng chục lần
| Tác vụ ComfyUI (tham khảo) | MacBook Pro M1 Max 32 nhân GPU | PC RTX 5080 |
|---|---|---|
| SDXL 1024×1024, 30 bước | Khoảng 45–70 giây/ảnh | Khoảng 3–5 giây/ảnh |
| Flux.1 Dev 1024×1024, 20 bước | Khoảng 2–4 phút/ảnh | Khoảng 10–20 giây/ảnh (FP8/FP4) |
| Video Wan 2.x / LTX-2 vài giây | Rất chậm, nhiều workflow không chạy được | Vài phút, chạy được với bản FP8/GGUF |
| Upscale, ControlNet, IP-Adapter | Chạy được nhưng chậm | Nhanh, hỗ trợ đầy đủ |
Khi làm ComfyUI, bạn thường phải thử hàng chục, hàng trăm lần để ra một ảnh ưng ý. Chênh lệch vài giây với vài phút mỗi lần chạy khiến trải nghiệm hoàn toàn khác nhau: trên RTX 5080 bạn sáng tạo liên tục, còn trên M1 Max bạn phải chờ.
Hệ sinh thái CUDA: lý do quan trọng không kém tốc độ
ComfyUI có hỗ trợ Mac qua nền tảng MPS (Metal) của PyTorch, nhưng phần lớn cộng đồng phát triển trên CUDA. Hệ quả là trên Mac bạn sẽ gặp:
- Nhiều custom node chỉ chạy trên NVIDIA: SageAttention, xformers, TensorRT, Nunchaku, bitsandbytes…
- Không có phần cứng hỗ trợ FP8, FP4; chip M1 cũng không hỗ trợ bfloat16, nên mô hình mới như Flux phải chạy ở FP16/FP32 hoặc GGUF, chậm hơn và đôi khi ra ảnh đen, lỗi.
- Workflow chia sẻ trên mạng thường được thử trên GPU NVIDIA; mang sang Mac hay phải chỉnh sửa, thay node.
Trong khi đó, RTX 5080 với nhân Tensor thế hệ 5 được NVIDIA và ComfyUI tối ưu riêng cho định dạng NVFP4 và FP8. Theo NVIDIA, các bản cập nhật ComfyUI năm 2026 giúp tăng tốc trung bình khoảng 3 lần với NVFP4, 2 lần với FP8 và giảm khoảng 60% bộ nhớ sử dụng trên RTX 50 Series. Nhờ vậy 16GB VRAM vẫn chạy thoải mái Flux, Qwen-Image và nhiều mô hình video.
Giới hạn 16GB VRAM khi làm ComfyUI
RTX 5080 không hoàn hảo: một số mô hình video lớn hoặc Flux ở độ phân giải cao với nhiều LoRA, ControlNet có thể vượt 16GB. Khi đó bạn cần dùng bản nén FP8/NVFP4/GGUF, bật chế độ tiết kiệm VRAM hoặc chấp nhận ComfyUI đẩy bớt sang RAM. Nếu làm video AI chuyên nghiệp, RTX 5090 32GB sẽ thoải mái hơn, nhưng với đa số người dùng, RTX 5080 đã dư sức.
Những yếu tố khác cần cân nhắc
Huấn luyện, fine-tune mô hình
Nếu bạn muốn huấn luyện LoRA cho ảnh (kohya_ss, ai-toolkit) hoặc fine-tune LLM nhỏ (Unsloth, Axolotl), PC NVIDIA gần như là lựa chọn duy nhất thực tế. Mac có MLX hỗ trợ fine-tune LoRA cho LLM, nhưng tốc độ và công cụ hạn chế hơn nhiều, còn huấn luyện LoRA ảnh trên Mac rất chậm.
Di động, điện năng và tiếng ồn
MacBook Pro M1 Max là laptop có pin, màn hình Liquid Retina XDR đẹp, chạy AI cả ngày vẫn êm và mát, tiêu thụ chỉ khoảng 60–100W khi tải nặng. Bạn có thể mang mô hình 70B đi họp, đi công tác mà không cần Internet. PC RTX 5080 cần nguồn 850W, chạy liên tục tốn điện hơn đáng kể và ồn hơn, nhưng đổi lại tản nhiệt tốt cho các phiên chạy dài nhiều giờ.
Khả năng nâng cấp và tuổi thọ
PC Windows nâng cấp được: thêm RAM để chạy MoE tốt hơn, thay card mạnh hơn sau vài năm, thậm chí gắn thêm card thứ hai. MacBook Pro M1 Max không nâng cấp được bộ nhớ, đã ra mắt từ 2021 nên hiệu năng AI thấp hơn nhiều so với chip M4, M5 hiện nay. Đổi lại, hàng cũ có giá dễ chịu và vẫn được macOS hỗ trợ.
Nếu bạn cân nhắc laptop RTX 5080
Laptop gaming RTX 5080 như Alienware 16 Area-51 RTX 5080 64GB vẫn có 16GB VRAM và toàn bộ lợi thế CUDA khi làm ComfyUI, nhưng hiệu năng thấp hơn bản desktop khoảng 25–35% do giới hạn công suất. Đây là lựa chọn hợp lý nếu bạn cần cả tính di động lẫn ComfyUI nhanh, chấp nhận máy nặng và pin ngắn khi chạy AI.
Nên chọn máy nào? Gợi ý theo nhu cầu
| Nhu cầu chính | Nên chọn | Lý do |
|---|---|---|
| ComfyUI, tạo ảnh/video AI | PC RTX 5080 | Nhanh hơn hàng chục lần, hỗ trợ CUDA, FP8/FP4 đầy đủ |
| Chatbot, lập trình với mô hình 7B–14B | PC RTX 5080 | Sinh chữ nhanh gấp 2,5–3 lần, xử lý ngữ cảnh dài nhanh |
| Chạy mô hình 32B–70B, ưu tiên chất lượng câu trả lời | MacBook Pro M1 Max 64GB | Nạp trọn mô hình vào bộ nhớ, chạy ổn định |
| Huấn luyện LoRA, fine-tune | PC RTX 5080 | Công cụ huấn luyện gần như chỉ dành cho CUDA |
| Cần mang đi, làm việc mọi nơi, dữ liệu riêng tư | MacBook Pro M1 Max 64GB | Laptop êm, pin tốt, chạy offline |
| Vừa ComfyUI vừa cần di động | Laptop RTX 5080 | Giữ lợi thế CUDA, chấp nhận nặng và ồn hơn |
Tóm lại: RTX 5080 + Windows là lựa chọn mạnh và linh hoạt hơn cho đa số nhu cầu AI local, đặc biệt là ComfyUI, tạo ảnh, video và huấn luyện. MacBook Pro M1 Max 64GB chỉ thực sự vượt trội ở một điểm: chạy được mô hình ngôn ngữ lớn hơn 16GB một cách êm ái, kèm lợi thế laptop di động.
Nếu bạn yêu thích hệ sinh thái Apple và muốn chạy LLM rất lớn với tốc độ tốt hơn nhiều, có thể cân nhắc dòng mới như Mac Studio hoặc MacBook Pro M5 Max với băng thông và bộ nhớ lớn hơn hẳn M1 Max.
Mua MacBook Pro M1 Max và laptop RTX tại mac365.vn
mac365.vn đang có sẵn MacBook Pro cũ các bản M1 Max 64GB như MacBook Pro 16 inch 2021 M1 Max 32GPU 64GB/1TB và MacBook Pro 14 inch 2021 M1 Max 32GPU 64GB/1TB, được kiểm tra kỹ phần cứng, không dính iCloud, bảo hành 6 tháng. Với nhu cầu ComfyUI và AI trên Windows, bạn có thể tham khảo các mẫu laptop gaming và laptop đồ họa dùng card RTX 50 Series.
Bạn chưa chắc nên chọn cấu hình nào cho mô hình AI mình định chạy? Hãy liên hệ mac365.vn để được tư vấn theo đúng phần mềm và ngân sách của bạn.
Câu hỏi thường gặp
MacBook Pro M1 Max 64GB chạy được mô hình AI nào?
Máy chạy tốt các mô hình 7B–32B và chạy được mô hình 70B nén 4-bit (khoảng 5–7 token/s) qua Ollama, LM Studio hoặc llama.cpp. Với ComfyUI, máy tạo được ảnh SDXL, Flux nhưng chậm hơn nhiều so với PC dùng card NVIDIA.
RTX 5080 16GB có chạy được mô hình 70B không?
Có, nhưng phải đẩy phần lớn mô hình sang RAM hệ thống nên tốc độ chỉ khoảng 2–4 token/s, thường chậm hơn MacBook Pro M1 Max 64GB. RTX 5080 phù hợp nhất với mô hình từ 24B trở xuống hoặc mô hình MoE.
Chạy ComfyUI nên chọn Mac hay PC NVIDIA?
Nên chọn PC hoặc laptop dùng card NVIDIA. ComfyUI và phần lớn custom node được phát triển trên CUDA, RTX 5080 tạo ảnh nhanh hơn M1 Max hàng chục lần và hỗ trợ FP8/FP4 để tiết kiệm VRAM.
Laptop RTX 5080 có thay được PC RTX 5080 để chạy AI không?
Laptop RTX 5080 vẫn có 16GB VRAM và đầy đủ CUDA nên chạy được cùng loại mô hình, nhưng chậm hơn bản desktop khoảng 25–35% do giới hạn công suất, máy nóng và ồn hơn khi chạy lâu.
Có nên mua MacBook Pro M1 Max cũ để học AI không?
Có, nếu bạn chủ yếu dùng chatbot, lập trình, chạy LLM offline và cần laptop di động. Nếu muốn làm ComfyUI, tạo video AI hoặc huấn luyện LoRA thường xuyên, nên đầu tư máy có card NVIDIA.